2026-11-05 05:43:53 分类:GEO优化
你刷电商时搜“苹果手机14”能精准跳转到对应商品,而不是跳卖红富士的页面,背后就是知识图谱与实体识别在跑。
真的。
日常里的两者配合,根本没你想的那么远
实体识别干的事,说白了就是从一段文字里把有实际意义的“实体”揪出来——不管是人名、地名、商品名,还是专业术语。
知识图谱干的事,就是把这些实体之间的关联关系存起来,像个超大的关系网。
举个例子,用户在评论区发“周末想去吃南门涮肉,最好是靠近国贸的分店”。
实体识别会先把“南门涮肉”(餐饮品牌)、“国贸”(商圈)、“周末”(时间)这几个实体标出来。
知识图谱里早就存好了关联:“南门涮肉-分店-国贸店”“国贸店-地址-CBD核心区”。
系统才能直接给你推对应的门店地址和排队情况。
说实话,之前帮朋友做小的本地生活检索工具,刚起步的时候踩的坑就是把所有“雷军”都当成了金山的那个老板,根本没考虑用户有时候搜的是同名的考研老师,你说冤不冤?
 电商搜索实体识别区分苹果手机和红富士示意图
落地时容易踩的几个实操坑
别上来就求大求全。
不要一开始就搭建全领域的实体库。比如你是做校园二手书检索的,就先把书名、专业、作者、课程号这些和书相关的实体录清楚,别上来又搞球鞋又搞演唱会门票,最后哪个领域的匹配准确率都上不去。
还有个容易忽略的点:实体的别名和歧义要单独做校验表。比如“冰城”是哈尔滨的城市别名,也是本地一家开了二十年的烤串连锁品牌,要是不把这个边界划清楚,用户搜“冰城有啥好玩的”,系统说不定直接推烤串店的菜单。
从实操角度看,前期花一周整理高频出现的歧义实体,后期的匹配准确率提升幅度,往往比上来就堆大模型参数要明显。
据一些用户反馈,不少小团队在做工具的前三个月,根本不需要用复杂的大模型做实体识别,用规则加少量标注数据就能满足80%的日常需求。
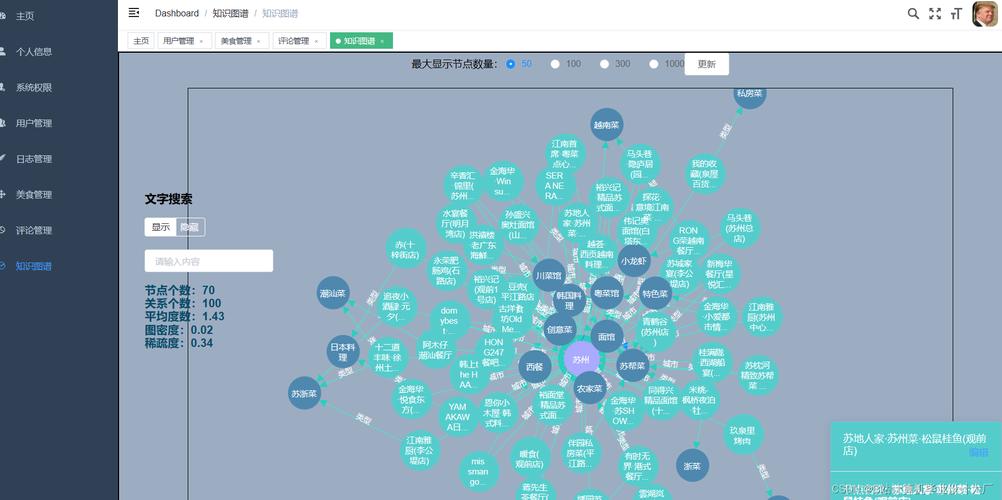 本地餐饮知识图谱实体关联示意图
有了大模型之后,这俩工具会被替代吗?
很多人问过这个问题。
答案显然是否定的。
大模型擅长生成流畅的文本,但有时候会“一本正经的胡说八道”——比如你问某上市公司2023年的公开营收,它可能根据训练数据里的旧信息瞎凑个数。
但如果先用实体识别,把问题里的“某上市公司”“2023年”“营收”这几个核心字段抠出来,再去知识图谱里调取已经录入好的、经过校验的财报公开数据,生成的回答就不会出现事实偏差。
有意思的是,现在不少做智能客服的团队,已经把这俩工具当大模型的“事实外挂”用了。
毕竟谁也不想接用户投诉,说机器人连“支付宝”和“微信支付”的功能都能搞混对吧?
你在搭建这类工具的时候,还遇到过哪些奇葩的实体识别歧义场景?欢迎结合具体情况聊聊。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:知识图谱与实体识别:落地场景和实操注意事项
文章链接:https://ttrenwu.com/geo/3681.html
