什么是日常里的多模态内容检索
说白了就是跳出“输文字找文字”的传统检索逻辑,支持把文字、图片、音频、视频片段随便当检索入口,匹配跨媒介的关联内容。
举个很日常的例子:通勤路上刷到博主拍的街角老槐树短视频,想找附近同款的可拍照点位,不用逐字抠文案输关键词,直接把视频里截的那张槐树图传上去,系统能同时识别画面里的树、路牌、路过的行人穿着,把关联的图文笔记、探店视频、用户投稿的实拍素材都匹配出来。

说实话,之前我自己找刷到过的BGM,得反复倒回去记半句歌词,现在直接截10秒音频丢进去,3秒就能出结果。省老多事了。
实际使用时容易踩的几个误区
很多人觉得传的素材越清晰、细节越全,检索结果越准?不对。
如果上传的实拍图带了太多无关杂物,系统会把杂物的特征也纳入匹配维度,反而容易跳出一堆完全不相关的结果。这里要留意跨模态匹配的权重逻辑——据一些用户反馈,现在多数平台的多模态检索,对核心主体的匹配权重会高于背景元素,比如你传一张拍了奶茶杯的图,就算背景里有个路过的橘猫,结果优先推的还是同款式奶茶的相关内容,不会优先推猫的视频。
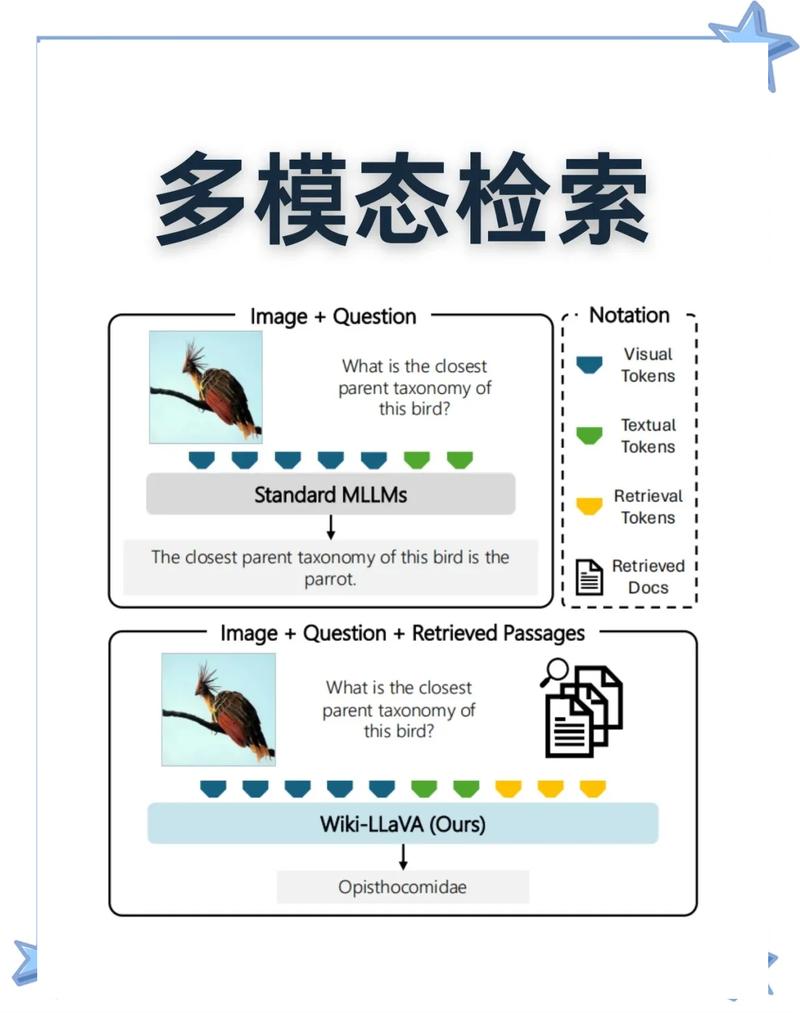
还有个容易混淆的点:多模态检索和传统以图搜图不是一回事。传统以图搜图只能找和你传的图像素高度相似的内容,多模态检索是找语义关联的——比如你传一张晴天拍的海边照片,传统以图搜图只会找同角度同天气的海边图,多模态检索能连带找出别人拍的同一片海的雨天vlog、附近的民宿推荐、甚至同款海边穿搭的笔记。
不同场景下的实操选择参考
如果是需要找素材做内容的创作者,通常可以优先选支持检索自有历史素材库的工具,不用每次都把全网内容翻一遍;如果是普通用户找日常刷到过的片段,直接用对应内容平台内置的多模态检索入口就行,不用特意跳转第三方工具。
从实操角度看,要是检索结果偏差太大,不用反复传原素材,稍微裁掉图里的无关边角、截掉音频里的环境杂音,准确率能提升不少。
您在实际使用中还遇到过哪些检索不准、结果跑偏的情况?欢迎结合具体场景继续探讨。
