不少人用大模型写方案、查资料时,都碰到过它张口就编不存在的文献、凑错误法条的离谱时刻。
反幻觉技术,就是嵌在大模型输出链路里,专门拦这类“无中生有”内容的基础能力。
日常接触的反幻觉能力,都藏在哪些环节
很多人以为反幻觉是个独立的大模型。
其实不是。它是嵌在输出全链路的一套校验逻辑,从模型生成内容的第一步就开始介入。
举个例子,你问大模型“2023年国内新能源汽车的平均售后维修时长”,如果模型训练库里没有对应公开数据,成熟的反幻觉逻辑会先触发检索,从权威公开数据源拉取匹配内容,而不是自己瞎编一个数字凑数。
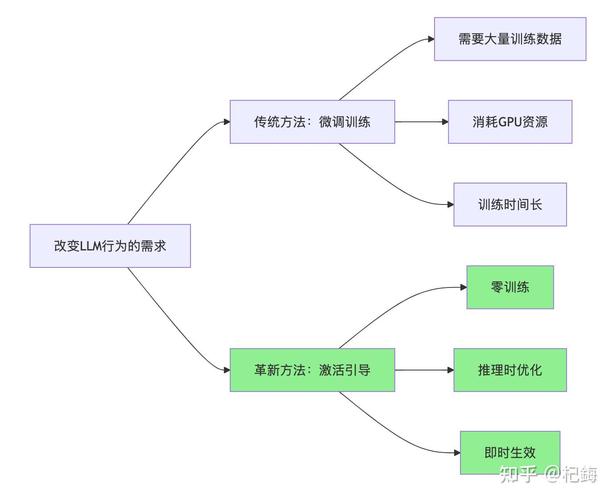
有意思的是,很多人熟悉的大模型联网搜索功能,本质就是反幻觉技术的常见外层落地形式。
据一些用户反馈,开启联网模式后,大模型编造不存在的历史事件、学术文献的概率,比纯离线模式低不少。
落地时容易踩的几个认知误区
很多人没意识到的是,没有任何一套反幻觉技术能完全消除幻觉。
它的作用是把幻觉出现的概率压到可接受范围,而不是让模型变成绝对正确的百科全书。
很多团队接入反幻觉模块时,容易上来就堆高配置的检索库,反而导致响应速度慢到没法用。从实操角度看,通常优先匹配自身业务的高频内容做校验库,比泛泛接入全网检索的性价比高很多。
比如做法律咨询类的大模型,优先把公开的现行有效法条、裁判文书做进专属校验库,比通用全网检索的精准度高不少。
还有个常见误区:觉得只要给模型加了检索就能解决所有幻觉。说真的,其实如果检索到的内容本身来源不靠谱,反幻觉模块没有做来源权重标记,模型还是会把错误内容当真话输出。
需要留意的是,目前行业通用的做法是给不同来源的内容设置可信度权重,官方公开渠道的内容权重远高于个人自媒体的零散内容。
和人工事实核查有啥本质区别
很多人会把反幻觉技术和人工事实核查混为一谈。
两者的介入节点完全不一样。
人工事实核查是在内容全部生成完之后,由人逐字逐句核对,通常用在对内容准确性要求极高的出版、官方公告场景。而反幻觉技术是嵌在模型生成的过程里,每生成一段内容就实时做校验,发现和检索库不匹配的内容就即时拦截或者替换,响应速度通常在百毫秒级,能适配普通用户的即时交互需求。
当然,反幻觉技术也有适用边界。碰到一些需要主观判断、没有统一标准答案的问题,比如“哪种职业发展路径更适合应届生”,它的校验逻辑就没法发挥作用——毕竟这类问题本身就没有统一的事实基准。
您在实际使用大模型的过程中,还碰到过哪些离谱的幻觉场景?欢迎结合具体情况继续交流。
