写论文、做内容合规审核、甚至给AI训练数据集做标注时,绕不开的一件事就是给手里的引用条目打分。很多人对这件事的认知还停留在“凑够数就行”,压根没意识到低质量引用能直接把整个内容的可信度拖垮。
别把“引用数量”当评估标尺
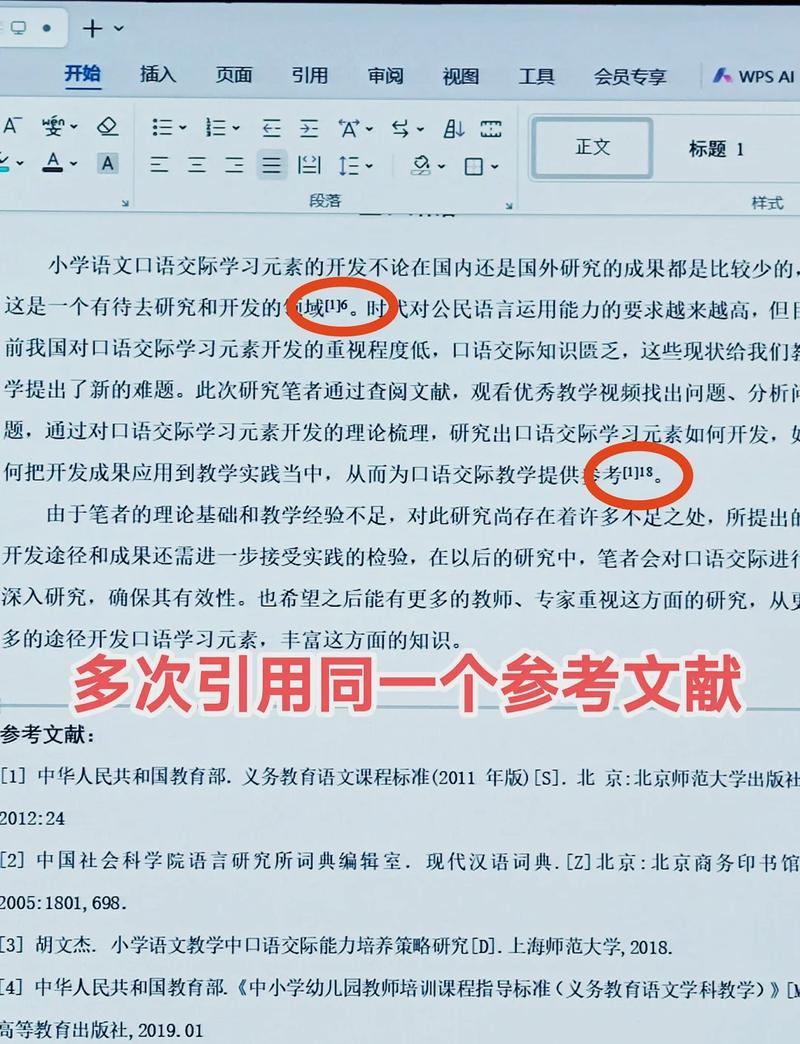
很多人列参考文献,光看个数够不够。凑够10篇就敢交差。哪管这些引用的来源是十年前的老教材,还是没人看的论坛碎帖。
据一些用户反馈,不少刚接触学术写作的学生,为了凑够引用格式,随便从相关话题的高赞回答里扒几句来源,连原文的核心观点都没核对过。
举个例子,你要写关于短视频用户留存的分析稿,引用一条2018年的早期行业报告,不如引用2024年公开的平台季度数据——前者的样本环境和现在的用户习惯早就隔了好几个版本迭代。
说白了,评估的核心从来不是你列了多少条来源,是这些来源能不能真的给你写的内容托底。
实操时别漏了这几个核对细节
我们通常可以从两个核心维度做初步判断。
来源的可追溯性。就是你顺着引用标注的信息,能顺顺当当找到对应原文的位置,不是那种转了三手的二手转述。比如很多人攒的引用,标了某篇期刊的名字,翻遍全文都找不到对应表述,这种引用的参考价值基本可以忽略。
观点的匹配度。不是来源够正规就行,是这个来源说的内容,能不能直接支撑你现在写的论点。比如你要论证“长视频平台会员流失率上升”,你引了一条“短视频平台用户日均使用时长破3小时”的内容,哪怕这个来源是正规机构发布的,和你的论点不搭,也不算合格的引用。
说实话,这个环节特别容易踩坑。很多人为了找个看起来够硬的来源,硬把不相关的内容往自己的论点上靠,最后写出来的内容逻辑全是断的。
绕开这几个常见的评估误区
别觉得只要是核心期刊发的内容,就全是合格引用。
有些期刊上的综述类文章,本身就是整合其他学者的观点做的二手梳理,如果你引用的是这篇综述里提到的、但你根本没看过原文的研究内容,本质上还是在转述别人的总结,质量比你直接找一手原文要打不少折扣。
有意思的是,很多人会觉得引用的内容越旧越有权威性。其实在技术迭代快的领域,三年前的行业结论可能早就被新的研究推翻了。
从实操角度看,现在很多做AI内容生成的团队,也在把这套引用质量评估的逻辑放进内容生成的校验环节——毕竟AI生成的内容如果引了一堆没来源、不匹配的内容,用户根本不敢信。
您在实际整理引用素材的过程中,还遇到过哪些看起来权威实则经不起核对的情况?欢迎结合具体场景继续探讨。
