2026-10-16 04:17:08 分类:GEO优化
我们平时搜”杭州开了三十年的杭帮菜馆”能直接拿到精准排序结果,背后就有知识图谱与实体识别在发挥作用。
先搞懂:这俩技术到底在解决啥问题
很多人刚接触时会把这两个概念拆得特别开,其实压根不是。实体识别是知识图谱的主要进料口。
没有实体识别,知识图谱就是个空架子。要把零散的网页、文档、对话信息拼成可查询的网状结构,第一步得先把文本里的人、事、物、地点精准抠出来,给它标对身份,还要做好实体消歧,不然拼出来的全是错位的乱码。
举个大家都碰到过的例子:你搜”苹果”,没有实体识别的消歧逻辑,系统根本不知道你要找的是能吃的水果,还是做消费电子的品牌。真的。要是消歧逻辑崩了,搜”苹果”能给你跳出一堆果园采摘的攻略,和你要找的手机参数半毛钱关系没有。
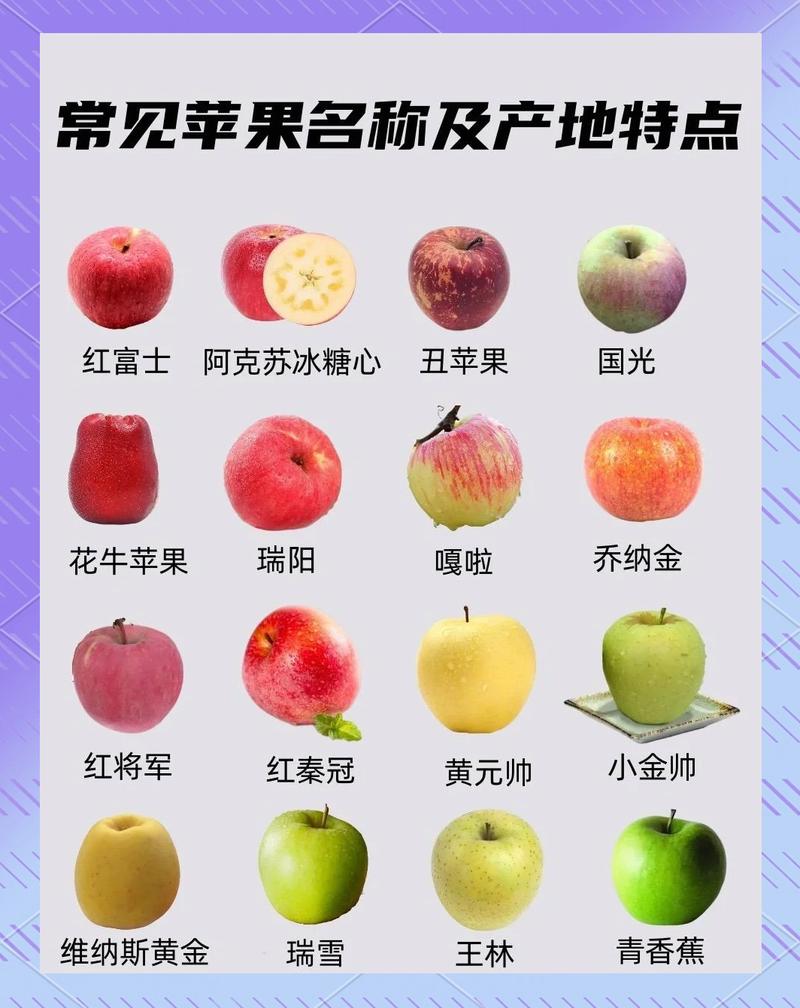 实体识别消歧水果与品牌苹果示意图
说实话,这种消歧逻辑,日常用的时候你根本感知不到,但它要是出问题,搜出来的结果能离谱到让你笑出声。
实操里容易碰到的几个坑
据一些用户反馈,不少团队刚开始落地时,会直接拿通用实体识别模型跑垂直场景的任务,最后准确率掉得一塌糊涂。
问题出在哪?通用模型的训练数据覆盖的是大众熟知的实体,要是你做的是本地餐饮的知识图谱,那些开在老小区里的夫妻店、小众的特色菜名,通用模型根本认不出来。
需要留意的是,实体识别不是一劳永逸的事。今年新出的小众文创品牌、刚开业的社区书店、新上映的小众导演作品,都属于模型没收录的新实体,要是不及时补进实体库,后续知识图谱的关联逻辑就会全错。
别嫌麻烦。小团队不需要搞复杂的自动更新流程,每周抽1小时整理下最近碰到的新实体,基本就够用了。
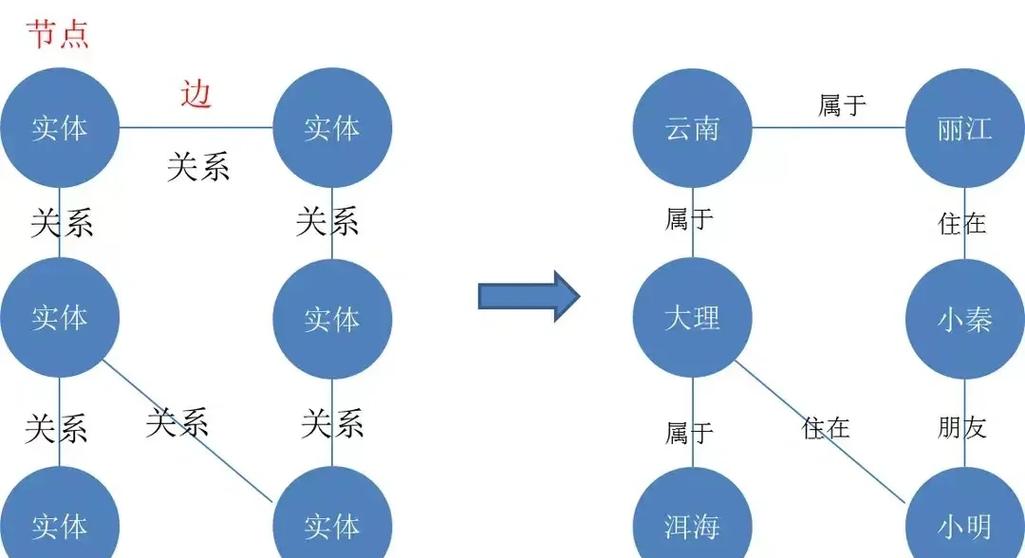 知识图谱实体关联网状结构示例图
没你想的那么远:普通用户也能用上的场景
很多人觉得这俩技术是大厂搞搜索、搞大模型才用的东西,其实离日常很近。
比如你自己做个本地书单管理,用开源的实体识别工具把每本书的作者、出版社、所属品类抠出来,拼成自己的小型知识图谱,之后找书的时候直接搜”和《人类简史》同类型的非虚构作品”,比翻杂乱的文件夹效率高得多。
有意思的是,很多人以为实体识别就是”把文本里的名词标出来”,其实差得远——还要做身份匹配、属性补全,不是标个词性就算完成。
你在实际碰到这类技术应用的时候,还遇到过哪些意料之外的情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:知识图谱与实体识别:从日常场景到实操落地的实用梳理
文章链接:https://ttrenwu.com/geo/2869.html
