你搜”北京周末带娃去哪玩不晒”的时候,不用翻十页网页点链接,AI直接给你整理好带路线的攻略——这就是生成式AI搜索在干活。
基础认知:它和传统网页搜索到底差在哪
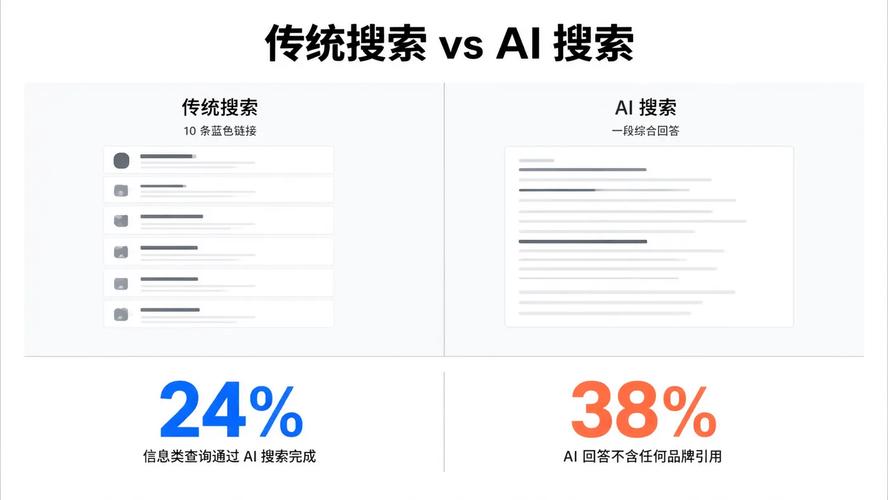
传统网页搜索的逻辑很简单,你输关键词,它匹配对应网页的链接,把排序后的结果甩给你,信息整理的活全要你自己干。对吧,谁没在找信息的时候翻到眼花过。
举个例子,你搜”2024年新能源汽车补贴退坡后普通家庭购车成本涨了多少”,传统搜索会给你政策原文、新闻报道、车企公告的链接,你得挨个点开找数据、算差价。
生成式AI搜索不会只给你甩链接。它会先把这些公开来源的内容抓回来,去重、筛选,再按你的问题逻辑直接整理成清晰的对比内容。
它的核心不是”生成”,是”检索后再生成”。
说实话,很多人第一次用的时候都会愣一下——怎么我没点进任何链接,答案就自己摆在眼前了?
核心逻辑:它按固定流程跑,不是”瞎编”
从实操角度看,生成式AI搜索的运行没有大家想的那么玄乎,几个核心节点走完,答案就出来了。
最先要过的是意图识别关。如果你的输入有歧义,它会先判断你真实的需求方向。比如你搜”苹果”,它会结合上下文判断你要查的是水果价格,还是最新款的手机参数。
过了意图识别这关,接下来就是定向检索的环节。它不会无差别爬取全网所有内容,通常会优先抓取来源可信度较高的公开内容,比如政府官网、权威媒体、正规经营主体的公开说明,不会把论坛里的零散水帖作为核心参考依据。
等检索的内容攒得差不多了,就进入整合生成的环节。它不会直接复制粘贴检索到的内容,会按照你问题的逻辑重新组织语言,必要的时候还会附上对应的内容来源,方便你回溯核对。
常见的认知误区
很多人觉得,生成式AI搜索的答案都是大模型”背下来”的。
真的。
据一些用户反馈,要是你问的是非常新的、还没被公开收录的内容——比如刚发布1小时的本地活动信息,它给出的答案就容易出现偏差,甚至会补一些不存在的细节。
需要留意的是,如果是涉及个人决策的信息,比如就医建议、合同条款解读,最好点它标注的来源链接二次核对,不要直接把生成内容当成最终判断依据。
您在实际使用AI搜索的时候,还遇到过哪些答非所问的情况?欢迎结合具体场景继续探讨。
