平时你搜”北京周末遛娃不晒的地方”,翻十页链接找攻略的日子,是不是早就被生成式AI搜索惯坏了?
别被概念绕,先搞懂它的基础运行逻辑
和传统搜索引擎靠关键词匹配链接的路子不一样,它从根上换了思路。
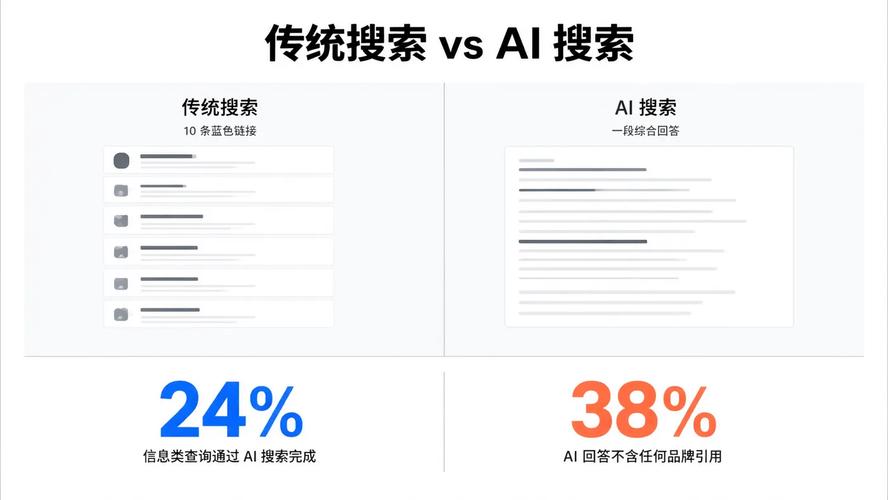
举个例子,你搜”3000元内适合拍宠物的微单推荐”,传统搜索会给你甩一堆电商页、测评文章链接,得你自己挨个翻着凑信息。但生成式AI搜索会先把全网抓来的相关内容拆成碎片化的信息块,先筛掉过时的广告内容,再把参数、用户真实评价、避坑提示拼到一起,直接给你成段的整理结果。
说实话,我第一次用的时候还愣了两秒——原来找信息真的不用自己当拼图工。
几个容易被忽略的实操细节
很多人觉得它搜出来的结果全对,这其实是常见误区。
据一些用户反馈,如果你搜的内容涉及非常细分的行业规则,它抓取的信息源如果没有覆盖对应的专业内容,很可能会出现看似通顺实则错漏的表述。
我们通常可以在搜这类内容的时候,在提问里加上”引用2023-2024年的公开行业报告内容”这类限定条件,能在一定程度上减少错漏。
还有个细节,它不会像传统搜索那样把所有链接都列出来,你要是想溯源,得主动点结果里标注的引用来源入口。
和你认知里的AI问答有啥区别

有意思的是,很多人会把它和普通的大模型对话搞混。
其实普通大模型的回答大多是基于训练时的存量知识库生成的,信息有固定的截止时间。但生成式AI搜索是实时联网抓取最新内容的——比如你问”最近新开的上海博物馆特展到哪天结束”,它能抓到当天刚更新的展讯,而不是拿训练库里去年的旧信息凑数。
从实操角度看,涉及实时性的查询,用它的搜索功能比纯对话模型靠谱不少。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
