2026-11-04 07:21:20 分类:GEO优化
你刷外卖平台搜”附近不辣的湘菜”,或者查企业工商信息时自动关联出的上下游合作方,背后都有知识图谱与实体识别在默默运行。
先掰扯清楚:这俩技术到底是怎么配合干活的
实体识别的核心作用,是从非结构化的文本里精准挑出有独立意义的信息单元。
举个例子,你在项目文档里写”张明上周去字节跳动,谈了和飞书相关的客户合作”。识别系统要做的,是把这句话里的”张明”(人名实体)、”字节跳动”(企业实体)、”飞书”(产品实体)精准摘出来,不会把”上周”错标成无关的时间类实体,也不会把”谈合作”拆成孤立的动作单元。
 中文文本实体识别标注结果示意图
这些被挑出来的实体不是孤立存着的。知识图谱的核心价值,是把这些零散的单元按真实的关联关系串成可检索的网络——比如张明是某SaaS公司的客户成功负责人,字节跳动是飞书的开发主体,这层关系一旦对应准确,你查相关合作记录的时候,就不会跳出来八竿子打不着的无关信息。
有意思的是,从实操角度看,不少企业不会一开始就砸钱搞全套定制方案,大多是先接入成熟的通用实体识别能力,再慢慢沉淀自己的行业实体关系库。不用一步到位。
实操里容易碰到的几个坑
需要留意的是,很多人刚上手的时候,会给识别模型喂太泛的标注数据。比如把所有带”苹果”的文本都标成水果实体,真碰到”苹果公司发布新系统”的场景,识别结果就会直接跑偏。
据一些用户反馈,哪怕是迭代了很多版本的通用识别模型,碰到垂直行业的专有名词也容易”懵”——比如医疗场景里的”冠脉搭桥”,要是没提前补入行业专有名词词典,很可能被拆成两个毫无关联的普通词组。
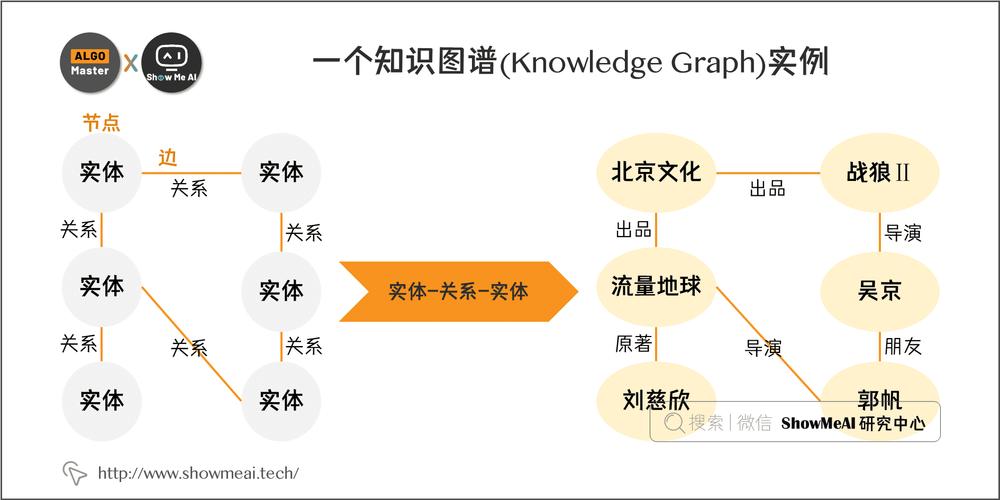 垂直行业知识图谱实体关联关系图
还有个常见误区:觉得知识图谱搭完就可以放着不管了。实际上实体的关联关系是动态变化的——比如某家公司换了法人,或者某条产品线停更了,要是不每季度做一次实体关系校准,过个大半年,图谱里的信息就会错漏百出,反而给日常业务添乱。
和你想的可能不一样:它不是大厂专属
这个可能因人而异,不少小团队觉得这俩技术是互联网大厂的算法团队才用得上的,其实现在很多通用工具已经把实体识别模块做的很轻量化了。
比如做内容运营的团队,用工具自动把往期3年的文章里提到的作者、线下活动、合作品牌全部识别出来,再串成简单的关联关系,做选题溯源的时候,根本不用翻几百篇旧文档找相关素材,省下来的时间能多做两版内容方案。
您在实际使用这类工具的过程中,还碰到过哪些识别偏差或者关系错配的情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:知识图谱与实体识别:从实操场景看它的落地逻辑
文章链接:https://ttrenwu.com/geo/3642.html
