你刷电商平台搜“适合敏感肌的保湿面霜”,系统能精准匹配到你之前看过的成分、肤质标签,背后跑的逻辑,就绕不开知识图谱与实体识别。
先拆解两个概念的日常落点
很多人第一次听这俩词,总觉得是离生活很远的技术名词。其实不然。
实体识别的核心作用,是从非结构化的文本里把独立的、有实际意义的信息单元拆出来。比如你在本地生活APP搜“周三晚上能带猫去的咖啡馆”,系统得先把这句话里的实体拆出来——“周三晚上”是时间实体,“带猫”是场景属性实体,“咖啡馆”是场所实体。

知识图谱的核心价值,是把这些散碎的信息单元按真实世界的关联逻辑串成可查询的网络。刚才拆出来的实体,要和后台的商家数据做匹配:哪个咖啡馆允许带猫,哪个店周三晚上正常营业,哪个店离你当前位置在3公里范围内。有意思的是,很多人以为这俩是高大上的实验室技术,其实你每次搜东西跳出的精准推荐,一半功劳在这。
没那么玄。
实操里容易踩的几个坑
从实操角度看,很多团队刚启动相关项目时,都会犯“贪多”的毛病。一开始就想做全量实体标注,恨不得把所有提到的东西都抓进图谱。这样做的维护成本会高到离谱。
比如做本地生活的图谱,没必要一开始就把咖啡馆的墙面颜色、老板姓什么都标成实体,先抓和用户决策相关的属性就够。之前接触过一个连锁茶饮的内部项目,团队一开始想把所有门店的设备型号、员工排班都做成实体,结果跑了三个月发现,用户根本不关心这些,反而漏标了“门店是否支持外带打包”这种高频查询属性。
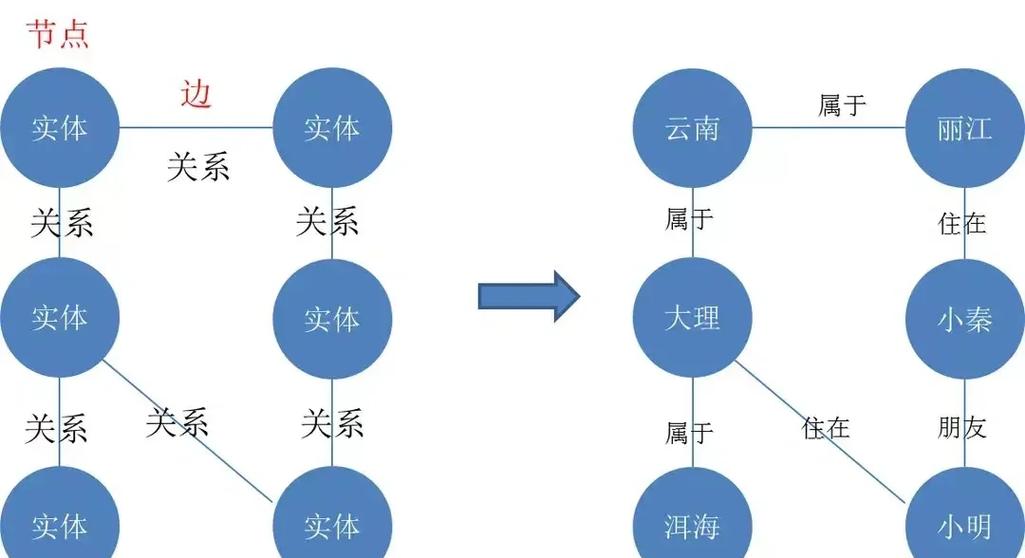
还有个常见误区:把实体识别的准确率当成核心考核指标。据一些用户反馈,做法律类文档的实体识别,哪怕漏了一个“原告”的身份标注,后续的关联逻辑全错;但做短视频内容标签的实体识别,偶尔把同名字的公众人物搞混,对整体推荐效果的影响其实没那么大。
需要留意的是,不同场景的容错阈值差很多,别拿着统一的准确率指标卡所有业务。
和固有认知不太一样的行业细节
很多人觉得现在实体识别靠大模型就能做到全自动,根本不需要人工介入。其实不是。现在较为常见的做法,是把大模型的识别结果,和人工校准的实体库做对齐。
比如提到“苹果”,到底是水果还是科技公司,得结合上下文的关联关系判断,不是光靠模型猜。你在搜手机配件的上下文里出现“苹果”,系统直接关联到品牌实体;要是在生鲜采购的上下文里,就关联到水果实体。
没有一劳永逸的判断标准。
你在实际使用这类技术的过程中,还碰到过哪些识别不准的乌龙场景?
