你搜“附近带猫咖的书店”时,搜索引擎能直接筛出符合条件的结果,背后就是知识图谱与实体识别在跑。
日常场景里的基础作用
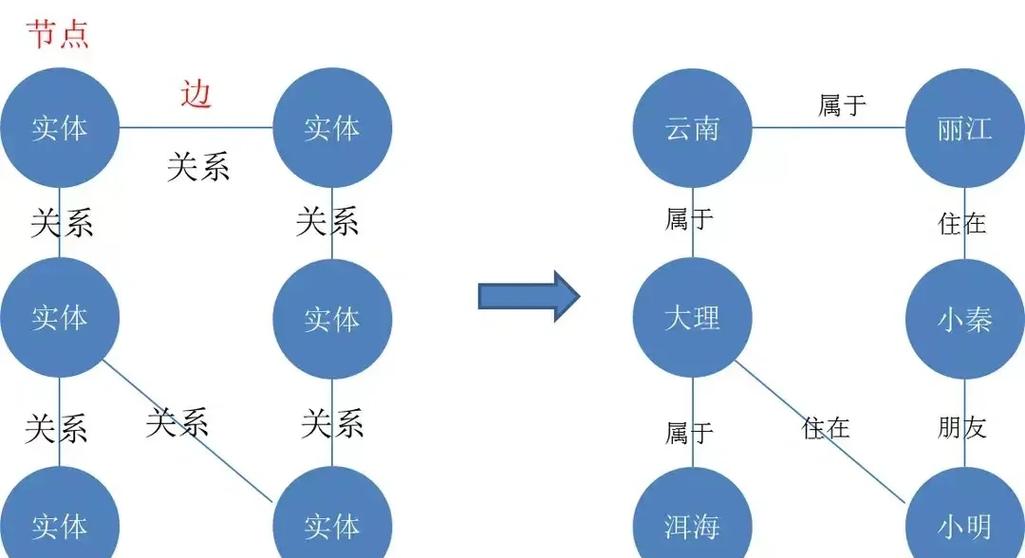
实体识别是把文本里的人名、地点、商品这些独立的“实体”抠出来,知识图谱再把这些实体的关联串成网。
举个例子,你在电商客服对话框发“去年买的那款红色保温杯漏水”,实体识别先抓出“红色保温杯”“去年订单”这两个实体,知识图谱再匹配你过往的订单记录,直接跳对应的售后入口,不用你翻半天订单。

有意思的是,很多人以为这俩是技术岗的专属,其实现在很多中小企业做内部文档检索,已经在搭轻量的知识图谱了,不用搞什么超复杂的大模型。
实操里容易踩的坑
别上来就追求大而全的实体库。
真的没必要一开始就把摊子铺太大。据一些用户反馈,刚开始搭的时候把公司所有部门、产品、供应商都塞进去,最后检索的时候反而混进很多无关信息,找个项目文档翻半天。我们通常可以先从高频使用的场景切入,比如先把销售团队常用的客户、项目、合同这三类实体标清楚,跑顺了再扩范围。
需要留意的是,歧义处理是个高频问题。比如同个名字“张磊”,可能是合作客户也可能是内部技术员工,要是没加属性标注,图谱关联的时候很容易串错。
容易混淆的概念边界

很多人会把实体识别和普通的关键词匹配搞混。
普通关键词匹配就是找文本里有没有固定的词,你打“苹果”,它就匹配所有带“苹果”的内容,不管是水果还是手机品牌。但实体识别会结合上下文判断,比如你在生鲜搜索页打“苹果”,它识别出来的是水果实体,要是在数码配件页打,就识别成品牌实体,再把对应的关联关系同步给知识图谱。
从实操角度看,这套组合的落地成本现在已经降了很多,不用专门养一个算法团队,用现成的开源工具就能搭个能用的基础版本。
您在实际使用中还遇到过哪些实体识别串错、图谱关联混乱的情况?欢迎结合具体场景继续探讨。
