打开手机搜“附近能接宠物的顺风车”,背后跑的就是知识图谱配实体识别的整套逻辑。
这事真不玄。
别抠晦涩定义,先看身边的真实应用
很多人觉得这是离普通人很远的黑科技。
其实拆解到很基础的逻辑,就是把文字里能对应到具体人、事、物的部分挑出来,再把这些东西之间的关联串成一张可检索的网。比如外卖平台上搜“适合老人吃的软口粤菜”,实体识别会先拆分出“软口口感”“粤菜品类”“适配老年群体”这几个核心要素,知识图谱再把平台上符合这些属性的餐馆、配送范围、用户评价里提到的软食细节关联起来,最后给出匹配结果。
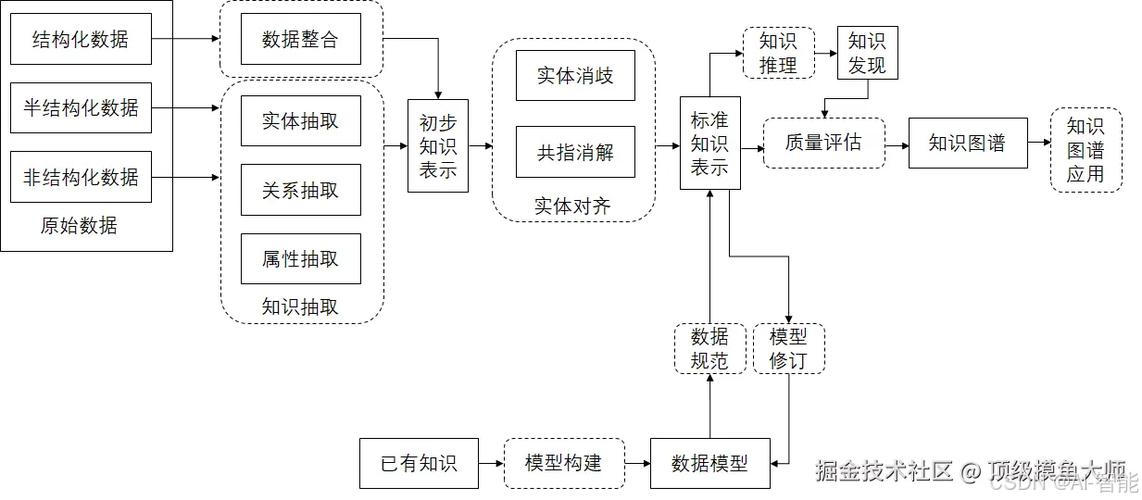
实操里容易踩的几个常见误区
比较闹心的问题从来不是识别不出来实体,而是把不同的实体搞混。
比如搜“苹果”,到底是生鲜水果还是数码品牌?据一些用户反馈,很多中小团队刚上线实体识别功能时,因为没给实体搭属性锚点,经常出现把水果类的苹果和数码品牌苹果的推荐内容混推的乌龙——给想买鲜果的用户推了手机壳,给想买手机的用户推了水果切配满减券。
这里要留意的是,实体识别不是光靠大模型硬猜,得给每个识别出的实体补全关联属性。比如“苹果(数码品牌)”关联“iPhone、iOS系统、线下授权门店”,“苹果(生鲜品类)”关联“维生素、鲜果配送、果切加工”,这就是很基础的同名实体消歧。

不用砸钱,普通人也能搭轻量版系统
别觉得这是只有大厂才能玩转的技术。
从实操角度看,个人做内容、做小生意,大多不需要买几十万的专业系统。比如做读书号的运营者,想给读者做关联推荐,完全可以先把每篇书评里提到的作者、代表作、同类型书单手动标记出来,存成简单的关联表格,慢慢攒数据,这就是一套轻量的知识图谱。读者看完一本的书评,自动推同作者其他书的相关内容,这类推荐的匹配度通常比无差别泛推要高。
这个可能因人而异,要是你做的是本地便民号,就把辖区里的社区、诊所、菜市场、办事点的信息按关联关系存好,用户问“附近打疫苗的地方”,直接调出对应信息就行,大多不需要复杂的算法模型。
您在实际使用中还遇到过哪些实体识别的乌龙情况?欢迎结合具体场景继续探讨。
