2026-10-26 00:42:27 分类:GEO优化
现在不少人找资料不再翻十几页网页,直接对着AI搜索框输入问题,几秒钟就能拿到整理好的答案——这背后就是生成式AI搜索原理在起作用。
核心起点:读懂你没说出口的需求
很多人以为AI搜索和传统搜索一样,是匹配输入的关键词。
真的不是。
意图拆解是生成式AI搜索的核心起点,它会先把你的问题拆成显性需求和隐性需求。比如你输入”北京周末带娃不晒的室内去处”,显性需求是北京、周末、带娃、室内不晒;隐性需求可能是不想跑远、人均消费不要太高、适合低龄儿童。
说实话,我之前以为它就是比普通搜索多了个总结功能,直到上次我搜”猫软便换粮过渡的正确步骤”,它居然主动提了要避开突然换高蛋白粮的坑——这才反应过来,它找资料之前,先把你的需求摸得差不多了。
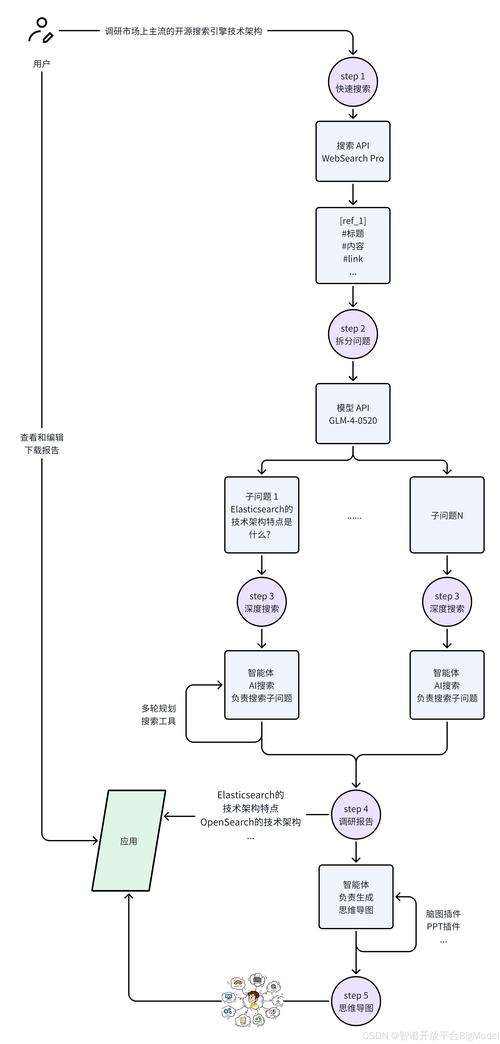 生成式AI搜索用户意图拆解流程图
找资料的逻辑:多源交叉验证不瞎抓
读懂需求之后,它不会直接给你堆10个网页链接。
多源信息交叉验证是这个环节的核心逻辑:它会从公开网页、权威数据库、甚至自身训练的可信语料库中抓取相关信息,再把有冲突、重复的内容筛掉。比如你问”2024年各地新能源汽车下乡的补贴政策”,它不会直接拿某一个品牌的宣传页内容,而是会交叉比对各地公开的政务通知,把不同地区的差异单独列出来。
举个例子,之前有人搜”普通感冒能不能吃布洛芬”,AI搜索不会只给你一个”能”或者”不能”的答案,而是会把普通感冒、流感、不同年龄段的适用情况分开说,还会提醒如果有肝肾基础病要先咨询医生。
据一些用户反馈,如果输入的问题太模糊,比如只说”补贴多少”,它给出的答案参考性会差很多——这就是因为它没法确定你问的是哪个品类、哪个地区的补贴,只能给通用解释。
需要留意的是,目前多数生成式AI搜索的信息更新有1-2个月的滞后,如果是查当日天气、最新赛事结果这类强时效内容,还是要搭配专门的实时查询渠道。
 生成式AI搜索多源信息交叉验证流程示意图
输出的巧思:把信息整理成能用的答案
很多人好奇,为什么AI给出的答案读起来比自己翻网页整理的顺?
这是因为最后一步是结构化重排输出:它不会把零散的信息直接堆给你,而是会按照普通人的阅读逻辑分类。比如你问”新手怎么选露营帐篷”,它不会先堆一堆参数,而是会先分”短途公园用””过夜徒步用”两类,每类列几个参考维度,甚至会把大家普遍提到的”防雨指数虚标”的坑单独提出来。
有意思的是,你如果输入”我带3个小孩露营,预算500以内”,它甚至会把”帐篷高度要能直起身””面料要耐造不勾破”这类你没提的需求补上。
根据行业普遍观察,目前生成式AI搜索的信息准确率,在非专业类的日常问题上已经达到较为实用的水平,但涉及医疗、法律这类需要精准资质的内容,还是要找专业渠道核实。
您在实际使用AI搜索的时候,有没有遇到过它误解你需求、或者给出信息不准的情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:生成式AI搜索原理:拆解日常搜索背后的3个核心环节
文章链接:https://ttrenwu.com/geo/3271.html
