平时搜个问题,以前是跳一堆网页链接让你自己挨个翻,现在的AI搜索直接给你整段整理好的结论。很多人好奇背后到底是怎么跑通的,真不是玄学。
先掰明白:它和传统搜索根本不是一个路数
差在哪?
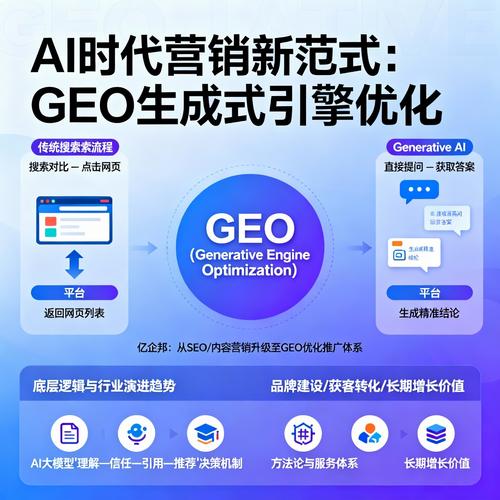
传统搜索引擎的逻辑很直接:你输入关键词,它在数据库里匹配权重最高的网页链接,按顺序排给你,找答案、整理信息的动作全靠用户自己完成。
比如你搜”杭州3月穿什么合适”,以前你会收到20来个旅游攻略链接,得挨个点进去翻气温、看穿搭建议,自己总结出适合带的衣服。现在的生成式AI搜索,会先把全网抓来的相关内容过一遍,直接给你整理成”3月杭州平均气温10-18度,早晚温差大,建议带件薄外套”这种现成的结论。
核心的第一步,不是直接检索,是先把用户的问题”拆碎”。
比如你输入的是长问句”我下个月带7岁小孩去成都玩3天,不喜欢人挤人的景点,有什么顺路的路线推荐”,它不会直接拿整句话去检索,会把问题拆成几个独立的判断模块:出行时间、同行人年龄、偏好(避开人流)、行程时长、路线顺路逻辑,每个模块对应找匹配的参考内容。
说实话,这步要是拆错了,后面给的答案全是错的——比如把”避开人流”识别成”喜欢热闹”,那出来的结果能看才怪。
关键的中间环节:不是照搬内容,是”拼接”有效信息
很多人以为它是直接从某个网页扒一段内容,根本不是。
据一些用户反馈,现在主流的生成式AI搜索,会先把检索到的几百条相关内容,按可信度、和问题的匹配度筛出前几十条,再把这些内容里的关键信息抽出来,拼成逻辑通顺的回答。

举个例子,你问”为什么喝冰的容易拉肚子”,它会把消化科医生的公开科普、营养学的公开研究、普通用户的真实体验这几类内容里的共性结论抽出来,不会只抄某一个博主的说法。
需要留意的是,它拼接内容的时候,要是某类信息的占比太高,很容易把小众的真实经验盖过去。比如很多人说自己喝冰的完全没有肠胃不适,但这类内容占比少,最后出来的回答可能就会默认”所有人喝冰的都容易拉肚子”,这个就是比较常见的认知偏差。
容易被忽略的细节:溯源机制是靠谱的重要支撑
别不信。
现在很多生成式AI搜索,不会只给你干巴巴的答案,会在每个结论后面标清楚引用的来源链接。从实操角度看,要是你看到的回答没有对应的溯源标注,那它的内容可信度就要打个问号——毕竟没有来源的话,你根本不知道它说的话是从哪来的,有没有凭空编造。
通常来说,标注了具体来源的回答,出现事实性错误的概率会低一些。
您平时用这类AI搜索的时候,有没有遇到过答案和实际情况对不上的情况?欢迎结合具体场景继续探讨。
