现在大模型答非所问、编瞎话的问题,反幻觉技术就是专门给这些不靠谱输出装“安全锁”的一套基础方法。
反幻觉到底在解决什么问题
别觉得这是高大上的技术概念。
比如之前有用户问大模型“某2023年上市的国产降糖药三期临床有效率”,大模型直接编了个92%的数值,连论文出处都给造了个假的。
这类无中生有的输出,就是反幻觉技术要拦的核心对象。
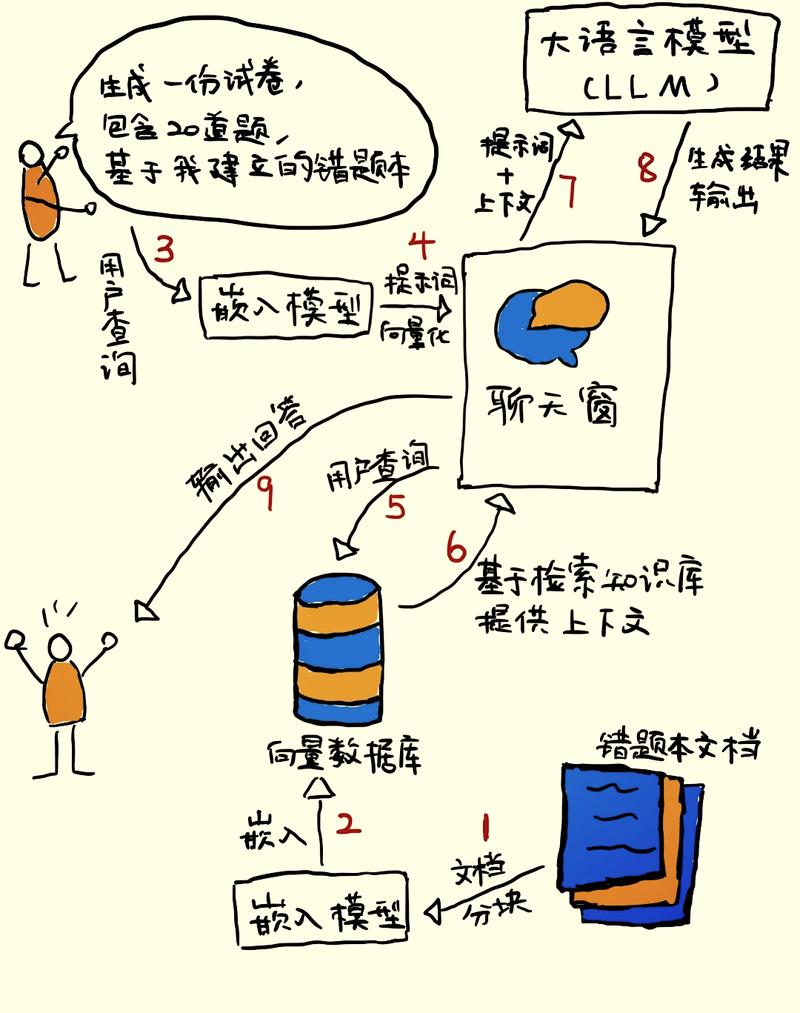
现在大部分落地的反幻觉逻辑,不是逼着大模型“变聪明”记住所有知识,而是给它的输出加一层“前置校验”——先查可信的外部知识库,再组织语言回答,不许凭空瞎编。
实操时别踩这几个常见坑
据一些用户反馈,不少人一开始以为套个现成的RAG框架就万事大吉,结果遇到知识库没收录的内容,大模型还是会硬编。真的。
举个例子,你给电商客服大模型加了反幻觉模块,但是知识库只更新到2024年3月的售后政策,用户问6月刚出的大件退换货规则,要是没设好“知识库未匹配就明确告知暂无相关信息”的规则,它还是会照着旧政策瞎答。
这里要注意校验阈值的平衡:设太严,大模型连“1+1等于几”这种常识问题都要反复拉取外部文档,响应速度会慢到没法用;设太松,明明是编造的内容也能蒙混过关。
一个容易被忽略的认知误区
很多人觉得反幻觉是大模型本身的能力升级,其实从实操角度看,现在多数中小企业能落地的反幻觉方案,都是外挂式的,不需要改动大模型本身的底层参数。
通常就是三个核心环节:给大模型划定可使用的知识范围,要求每条输出必须标注可信来源,再加一层规则校验,不符合要求的内容直接打回重写。
有意思的是,不少人担心加了反幻觉会让大模型变“笨”,实际上只要把“不知道就说不知道”的逻辑设好,反而会降低用户的不信任感。
你在使用大模型的过程中,遇到过哪些离谱的幻觉输出?欢迎结合具体场景继续探讨。
