你有没有过对着相册搜“去年夏天带橘子汽水的海边照片”,系统真的秒把对应内容捞出来的经历?这背后跑的就是多模态内容检索。
到底哪些场景在真正落地用
很多人刚接触这个概念,总觉得是离自己很远的前沿技术。
真不是!
普通人日常接触较多的场景,就是手机系统自带的相册搜索。你不用给每张照片改文件名、打标签,只要输入“雨天撑伞”“家里蹲猫的打哈欠瞬间”,系统就能把匹配的图、甚至带对应画面的短视频筛出来。
企业端的应用就更普遍了。比如电商平台里,用户上传一张自己家装的客厅图,想找同风格的落地灯,系统不用你手动选风格标签,就能从商品库的图、详情页、测评视频里,把匹配色调、设计感的内容检索出来。
实操里常遇到的几个误区
说实话,很多人用不好这类工具,根本不是技术不行。
从实操角度看,比较常见的问题就是对检索精度的预期错位。你总觉得输入几个模糊的词,系统就能精准get到你脑子里的画面。
别急着骂系统。
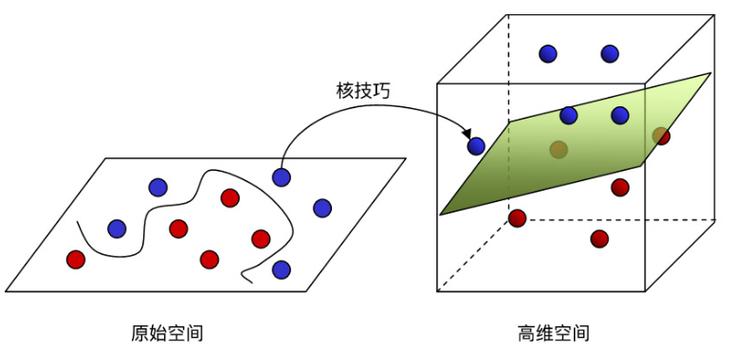
可实际上,多模态内容检索的核心逻辑是把不同类型的内容特征映射到同一个共享的向量空间,你给的特征维度越少,出来的结果偏差就越大。
比如你只在搜索框输“好看的视频”,系统根本不知道你要的是美食探店还是萌宠日常,结果自然离谱。
据一些用户反馈,企业搭建内部素材库的时候,常犯的错是把图片、视频、音频分别存储,没有提前做统一的特征对齐。最后搜“带海浪声的海边视频”,系统先把所有带“海边”二字的文档捞出来,根本匹配不上对应的音视频内容。
和传统关键词检索的本质差异
传统的关键词检索,本质是“字对字匹配”。你存的文件叫“IMG_20240601.jpg”,哪怕画面里全是橘子汽水,你搜“橘子汽水”永远找不到它。
多模态检索不一样。它能直接识别图片里的物体、视频里的动作、音频里的环境声,哪怕你从来没给文件加过任何文字标签,它也能读懂内容本身的信息。
这种检索方式在内容量较大的个人相册、企业素材库、电商商品库场景下,通常能大幅降低找内容的时间成本。
有意思的是,现在很多内容平台的推荐流,其实也用到了类似的多模态匹配逻辑——你刷到一条视频停了3秒,系统不是只看视频的标题标签,而是结合你之前看过的内容特征,判断这条内容和你的兴趣匹配度。
你在日常找照片、找素材的时候,遇到过哪些检索系统“看不懂人话”的情况?欢迎结合具体场景继续探讨。
