2026-10-21 22:33:02 分类:GEO优化
现在用大模型查资料、写方案的时候,最怕它一本正经编不存在的文献、瞎凑数据——反幻觉技术基础,就是给这些AI装“不说瞎话”的基础约束框架。
先拆明白:反幻觉技术到底在管什么
说实话,很多人对幻觉的认知还停留在“AI会瞎编”,但从实操角度看,常见的幻觉场景根本不是什么离谱的科幻设定。
比如你让它查某份2023年的行业报告数据,它能给你编出一个带具体小数点的数,连来源链接都给你凑得像模像样。
 大模型幻觉生成虚构文献页面对比图
我们通常说的反幻觉基础能力,核心不是让AI突然变聪明,而是给它套三层软边界:回答内容必须锚定你给的参考资料,碰到超出知识边界的问题要主动说不确定,不能为了凑回答逻辑硬补不存在的信息。
有意思的是,这套逻辑和我们平时写材料的规矩一模一样——写报告不能瞎编引用,没查到的内容要标注“待核实”,总不能为了凑字数瞎编对吧。
落地时容易踩的几个坑
很多人刚接触反幻觉技术的时候,容易把“调大模型温度参数”当成万能解法。
据一些用户反馈,花了大量时间调参数,最后发现AI该编还是编。为啥?因为基础的反幻觉机制根本不是单靠参数能搞定的。
需要留意的是,现在较为常用的基础反幻觉流程,核心是给回答划证据锚点——每一个事实性表述,都要对应到你上传的参考材料里的具体段落,没有锚点的内容就不允许输出。
举个例子,你用AI帮你整理会议纪要,如果开了基础反幻觉功能,它不会把你没提到的“下周启动项目立项”这种脑补内容写进去,只会严格锚定你上传的会议录音转写文本里的内容生成摘要。
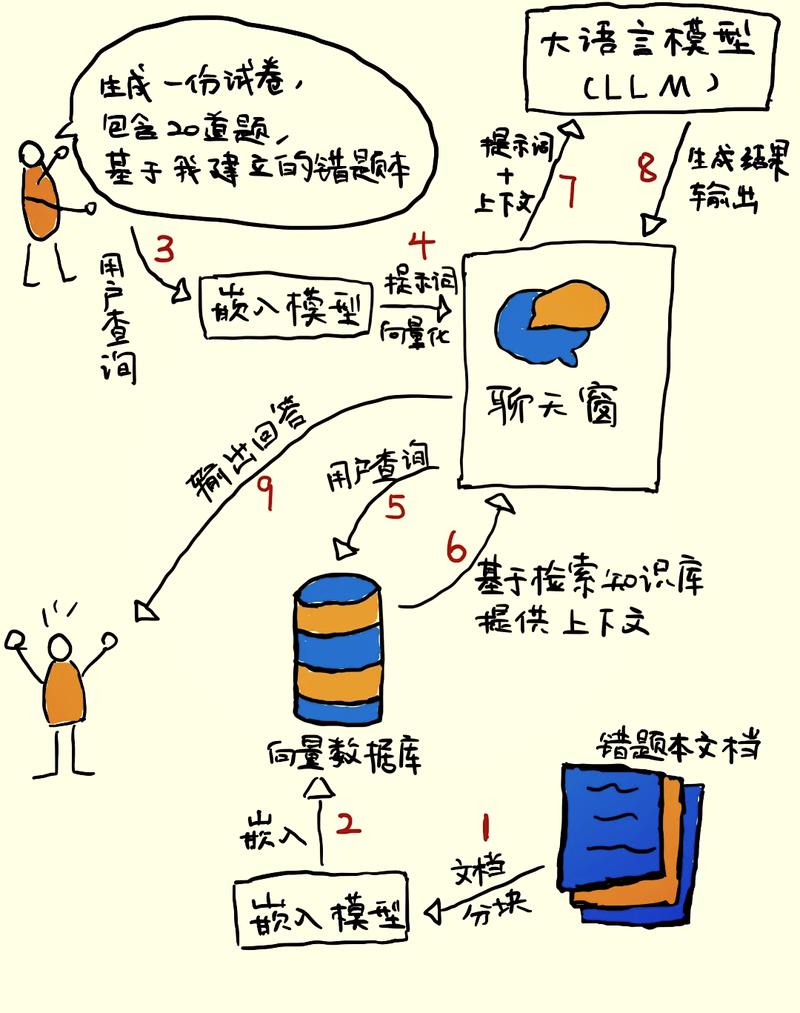 RAG反幻觉流程证据锚定环节示意图
别信什么“零幻觉”的宣传。根据行业普遍观察,只要是涉及开放域生成的场景,不管用什么基础技术,都没法完全消除幻觉,只能把幻觉出现的概率压到可接受的范围。
和普通内容生成的核心区别
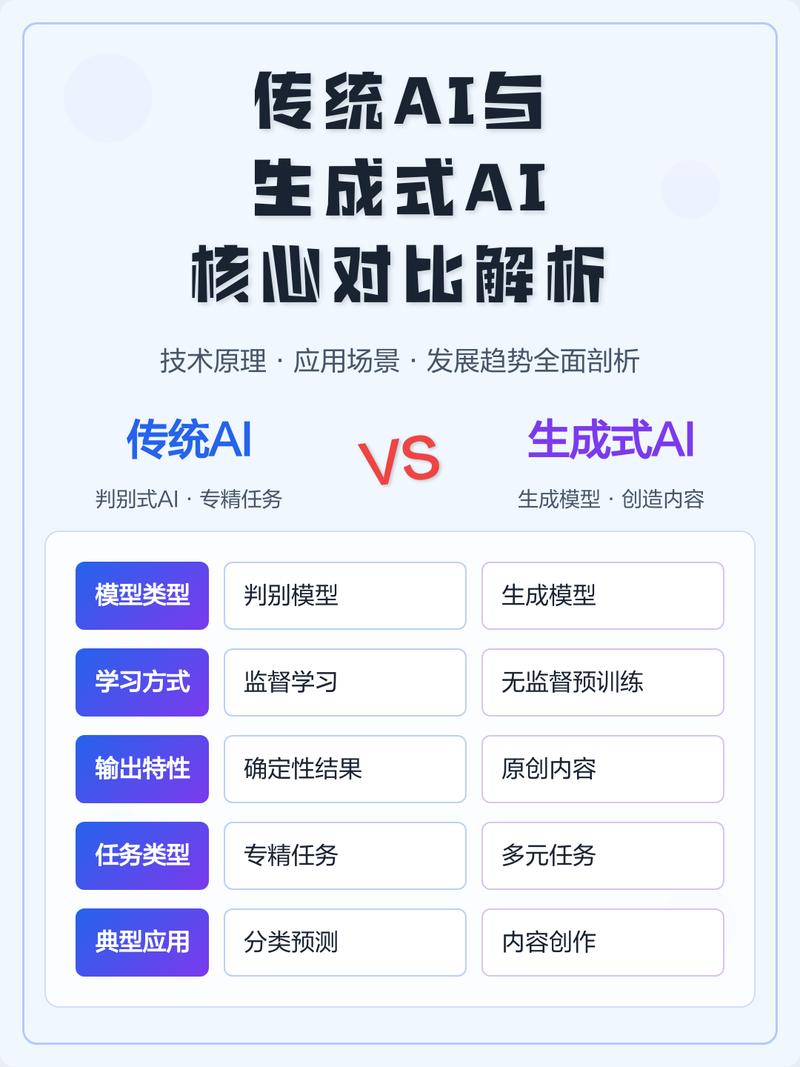 和普通内容生成的核心区别
这个可能因人而异,但从实际使用感受说,开了基础反幻觉功能的AI,回答不会那么“顺”。
以前没开的时候,AI会顺着你的提问把逻辑圆得特别丝滑,哪怕中间内容是编的。开了反幻觉之后,它碰到没把握的内容,会主动停下来提示“当前内容无参考依据,是否需要补充资料”,不会为了追求回答的流畅度硬凑内容。
对日常用AI做工作的人来说,这种“不那么顺”,反而是挺实用的价值。
您在实际使用大模型的过程中,还碰到过哪些离谱的幻觉场景?欢迎结合具体情况继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:搞懂大模型‘不瞎编’的底层逻辑
文章链接:https://ttrenwu.com/geo/3111.html
