你在购物平台搜“适合油皮的国货精华”时,系统能精准区分“油皮肤质”“国货品牌”“精华品类”三个独立信息单元,背后其实就是知识图谱与实体识别在跑。
基础认知:不是玄乎的概念,是信息的“分拣员”
实体识别本质是从非结构化的文本里,把有实际意义的“实体”挑出来——比如人名、地名、商品名、专业术语,再把这些实体之间的关联关系串起来,最后拼成能被机器读懂的知识网络,就是我们常说的知识图谱。
举个例子,你在病历里看到“3床患者对青霉素过敏”,实体识别要能精准挑出“3床”“患者”“青霉素”“过敏反应”这几个实体,还要关联上“患者-存在过敏史-青霉素”的关系,不是光把字挑出来就完事。
真的。
有意思的是,很多人以为这俩技术是大厂专属,其实现在不少中小团队做内部文档检索,已经在用开源的轻量模型做基础的实体抽取了。
实操踩坑:别把“抽词”等同于实体识别
很多新手团队刚搭系统时,会把关键词提取的结果直接当实体识别的输出,这其实差得远。
比如文本里写“苹果发布的新系统比华为的流畅”,如果只做关键词抽取,可能会把“苹果”识别成水果品类,“华为”识别成普通企业名,完全丢了实体的属性和关联逻辑。
据一些用户反馈,刚搭图谱的前3个月,80%的人工校准精力,都花在解决实体指代混淆的问题上。比如同一个“张三”,可能是公司的研发总监,也可能是外包项目里的供应商对接人,没有提前给实体加属性标签,后续查信息的时候很容易串线。
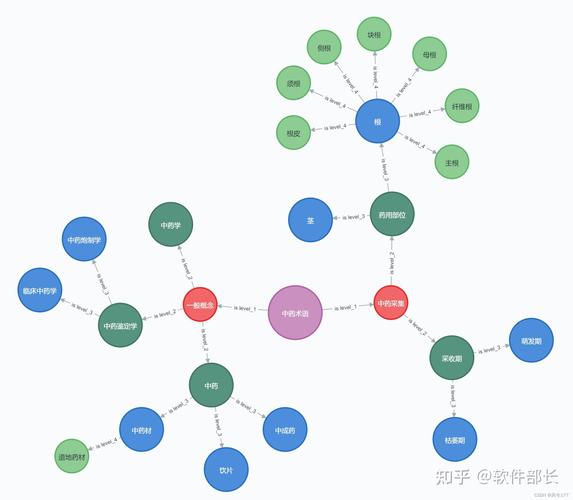
需要留意的是,实体识别的精度不需要无上限拉高,要匹配自己的使用场景——比如做内部员工通讯录的图谱,不需要纠结能不能识别网络热词,只要把人名、部门、项目组的关联关系搞准就行。
延伸视角:和传统关键词检索的核心差异
传统的关键词检索本质是字面匹配,比如你搜“北京 互联网公司 五险一金”,它只会把包含这几个词的文档按顺序列出来;但搭载知识图谱的检索,会先识别出“北京”是地域实体,“互联网公司”是行业类实体,“五险一金”是员工福利类实体,自动关联上这些主体对应的招聘信息、地址、过往评价,不需要你把所有相关关键词都打全。
这个可能因人而异,对追求检索效率的团队来说,这种关联能力能省不少翻文档的时间。
您在实际搭建知识库或者用智能检索工具时,还遇到过哪些实体识别不准的情况?欢迎结合具体场景继续探讨。
