现在搜东西碰到AI生成的回答,下面挂一堆带链接的引用,早就不是新鲜事了。很多人以为这是AI自己找的靠谱来源——其实差得远。
大语言模型的引用机制,到底在做什么
真没那么玄乎。
它不是传统学术写作里,写完论点再严谨标注出处的逻辑。更接近“先搭好回答的内容框架,再从检索到的公开网页里,找和框架内容沾边的链接,挂在对应的论断旁边”的流程。
比如你问“2024年国内露营市场的规模数据”,现在的AI回答不会直接甩一个数字,会在数字旁边标上[1][2]的角标,点进去能跳转到对应的公开网页。据一些用户反馈,很多时候这些跳转链接根本对不上前面的论断——就像你点进标着“数据来自公开行业报告”的链接,打开是个户外品牌的带货软文,离谱吧?
说白了,这套机制的核心,是给用户提供一个可溯源的参考路径,不是替你做内容真实性的终审。
日常使用时,哪些坑要提前留意
引用链接的权威性,和模型的匹配逻辑没有必然绑定。
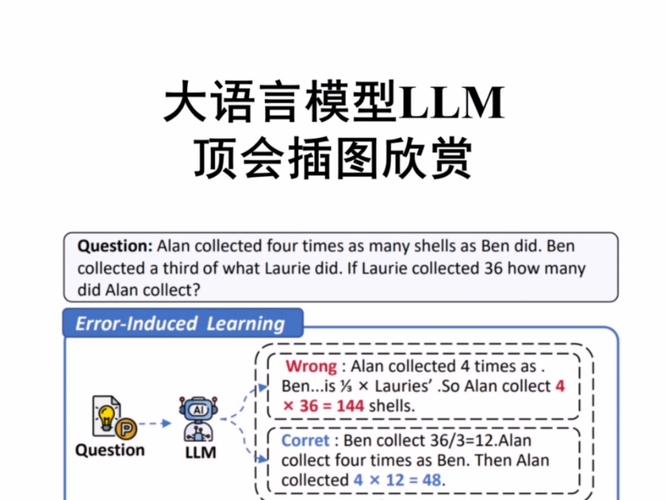
比如你问一个比较冷门的学术问题,模型可能抓了某个个人博客上的随笔当引用,哪怕那个博客的内容根本没有经过专业审核。举个例子,之前有人问“儿童过敏性鼻炎的日常护理注意事项”,AI给出的引用点进去是个卖洗鼻器的电商详情页,连临床指南的边都不沾。
从实操角度看,不要看到带引用的回答就直接全盘信。尤其是涉及医疗、法律、财务这类需要专业资质判断的内容,引用只是个参考起点,不是最终结论。
还有个很常见的误区:很多人觉得引用数量越多,内容越靠谱。真不是。别不信。有时候模型为了凑引用数,会把和核心论断完全无关的链接堆上去,比如讲新能源汽车续航的内容,引用里夹了个讲汽车日常保养的通用文章,凑数的痕迹特别明显。
这套机制现在的调整方向
说实话,现在各家做AI搜索的团队,都在补之前的漏洞。比如之前经常出现的“引用链接打不开”“链接内容和论断完全不搭”的问题,现在很多都加了语义匹配校验——如果抓到的链接和生成的内容相似度不够,就不会把它放到引用列表里。
有意思的是,有些团队还在做反向校验通道:如果某个公开网页的原作者,发现自己的内容被AI歪曲后当成引用,还可以提交申请,要求模型重新校准引用的对应关系。
这个可能因人而异,有的人觉得只要有引用就行,有的人非要每条引用都和对应的论断严丝合缝才肯信。但不管怎么说,比起之前AI张嘴就编、连个来源都没有的状态,现在的引用机制至少给用户开了个“动手查一下”的口子。
你平时用AI工具的时候,碰到过哪些引用错配的离谱情况?欢迎结合具体场景继续探讨。
