2026-10-16 11:16:24 分类:GEO优化
现在用大模型做客服、写内部文档的团队,几乎都遇过它瞎编的破事——反幻觉技术基础,就是帮你把这种离谱输出摁在合理边界里的整套底层逻辑。
先搞懂:反幻觉技术通常覆盖哪些环节
说白了,它不是某一个单独的工具,而是从输入到输出全链路的一套约束机制。举个例子,之前有个做企业内部知识库的团队,让大模型解答员工的考勤规则问题,它一本正经瞎编”入职满3年可享额外10天育儿假”,实际公司制度里根本没有这条——这就是典型的需要反幻觉技术拦截的场景。
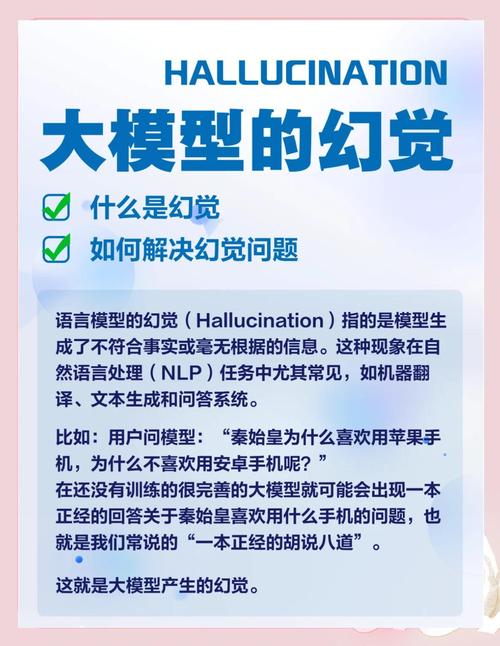 企业知识库大模型幻觉输出示例截图
这些约束不是等模型生成完内容才生效的,从一开始给模型喂什么检索材料,到生成过程中怎么引导,再到最后输出前的校验,每个环节都有对应的设计。
实操里的三个核心落地要点
我们通常从三个环节搭基础框架,不用追求一步到位。
检索源的可信度校验:不是把所有内部文档一股脑塞给向量库就完事,要先给文档打可信度标签——比如行政部正式发布的制度文档权重设为较高值,员工私下整理的经验分享权重调低,要是检索到的源本身就没实锤,模型根本不可能输出靠谱内容。
输出前的事实一致性校验:可以用参数更小的模型当”挑错员”,把大模型生成的内容和检索到的原文逐句比对,只要出现原文里没有的、无来源支撑的表述,就触发重新生成流程。
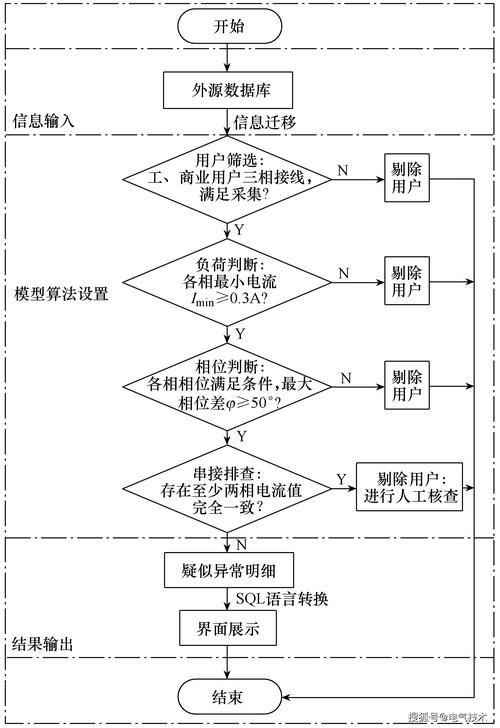 大模型输出事实校验流程示意图
模糊边界的兜底提示:如果检索到的信息不足以支撑完整回答,不要硬让模型凑答案,直接弹出”当前未检索到对应权威信息,建议咨询对应负责部门”的提示就行。
据一些用户反馈,把这个兜底逻辑加上之后,之前每周收到的十几条大模型答非所问的投诉,直接少了八成多。
容易踩的认知误区
别信那种说能彻底消除幻觉的宣传。
真的。
这个可能因人而异,不同场景对幻觉的容忍度本来就不一样:给用户做公开的产品参数答疑,幻觉的影响就很大;给内部员工写头脑风暴的创意草稿,偶尔有点发散反而不是坏事。有意思的是,很多团队一开始觉得反幻觉是个技术难题,落地之后才发现,大部分问题都是检索源没整理好导致的。很多团队容易走极端,要么把所有文档不加筛选全塞进检索库让模型自己找,要么把检索权限收的极严,模型连半句话都要翻三遍原文才敢说,最后输出的内容连基本的流畅度都保证不了。
您在实际使用大模型的过程中,还遇到过哪些印象深刻的幻觉场景?欢迎结合具体情况继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:大模型日常落地的实用避坑逻辑
文章链接:https://ttrenwu.com/geo/2880.html
