2026-10-15 04:29:56 分类:GEO优化
现在不少人用AI写方案、查行业数据,很在意输出内容到底有没有来源支撑,这背后绕不开大语言模型的引用机制。
基础认知:它到底是怎么工作的?
大语言模型的引用机制,本质是在生成回答前,先从模型收录的公开知识库中匹配和问题语义高度相关的内容片段,再把对应来源绑定到生成的结论后面。
举个例子,你问AI“2024年国内即时零售的市场规模增速是多少”,带引用功能的模型不会凭空编数字,会先匹配公开行业报告里的对应数据,再把报告来源附在结论旁。
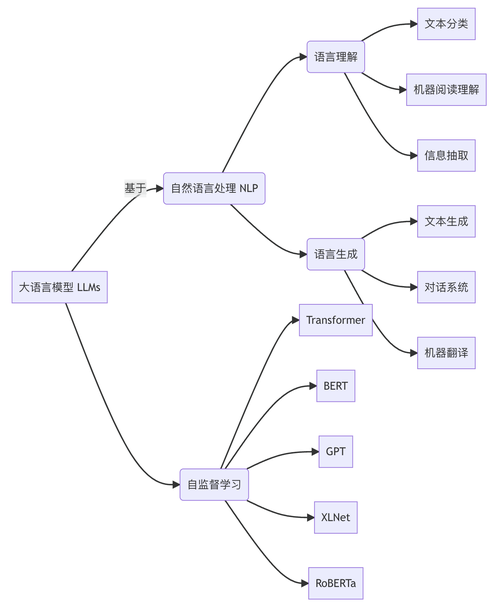 大语言模型引用匹配流程示意图
实操里容易踩的几个坑
说实话,很多人以为带了引用标的内容就完全靠谱,其实不然。
据一些用户反馈,部分模型的引用可能存在引用错位——明明结论来自2023年的行业报告,引用标却挂到了2022年的同主题文章上,普通用户顺着点进去很容易发现时间对不上。
我们通常可以养成两个小习惯:一是核对引用来源的发布时间、发布主体,不要看到有引用标就直接采信;二是如果涉及核心决策类的内容,尽量顺着引用链接找到原始文档交叉验证。
别光看标。很多时候模型的引用逻辑是基于语义相似度匹配的,不是严格的逐句事实溯源,哪怕语义匹配度差了几个百分点,也可能把来源挂错。
 大语言模型引用错位案例演示图
延伸视角:和无引用生成模式的区别
 延伸视角:和无引用生成模式的区别
没有内置引用机制的大语言模型,本质是靠概率预测下一个字的输出,很容易编造不存在的文献、数据,也就是大家常说的“幻觉”。
有意思的是,现在这类机制还在持续迭代,不是一劳永逸的。根据行业普遍观察,当前多数模型的引用优先级,会向公开可访问的高权重网页倾斜,对小众的学术博客、内部行业资料的匹配度就比较一般。
您在实际使用中还遇到过哪些引用相关的问题?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:大语言模型引用机制:普通人能用好的实操常识
文章链接:https://ttrenwu.com/geo/2828.html
