2026-10-14 16:55:01 分类:GEO优化
找一段只记得模糊旋律的短视频,或者一张只记得”穿蓝裙子在樱花树下”的旧照片,现在大多靠多模态内容检索完成。
日常里的多模态检索,根本不是什么”黑科技”
很多人对这个概念有距离感,觉得是大厂实验室里的前沿技术。其实你每天都在用。
比如手机相册里不用打标签的搜索功能,你输入”趴在窗台睡觉的橘猫”,系统直接匹配对应画面;又比如刷短视频时,用一段哼唱当音频片段,就能搜到对应的BGM和同款内容。
据一些用户反馈,哪怕是几年前拍的、从来没整理过的零散素材,现在也能靠这种方式快速定位,省了不少翻找的时间。
 手机相册多模态检索界面操作示意图
实操里容易踩的几个坑
别指望系统能精准猜到你模糊的记忆点。比如你只输入”找个猫的视频”,检索结果可能混进橘猫、黑猫、甚至动画里的猫形象,匹配范围会很散。
从实操角度看,给检索描述补1-2个具象细节——比如毛色、所在场景、当时的动作,能大幅缩小匹配范围。
还有个容易忽略的点,带叠加文字的内容,检索准确率波动比较大。比如你要找一张写着”季度复盘”的会议PPT截图,要是系统没识别到截图里的文字信息,很容易把别的带复盘话题的普通视频混进结果里。
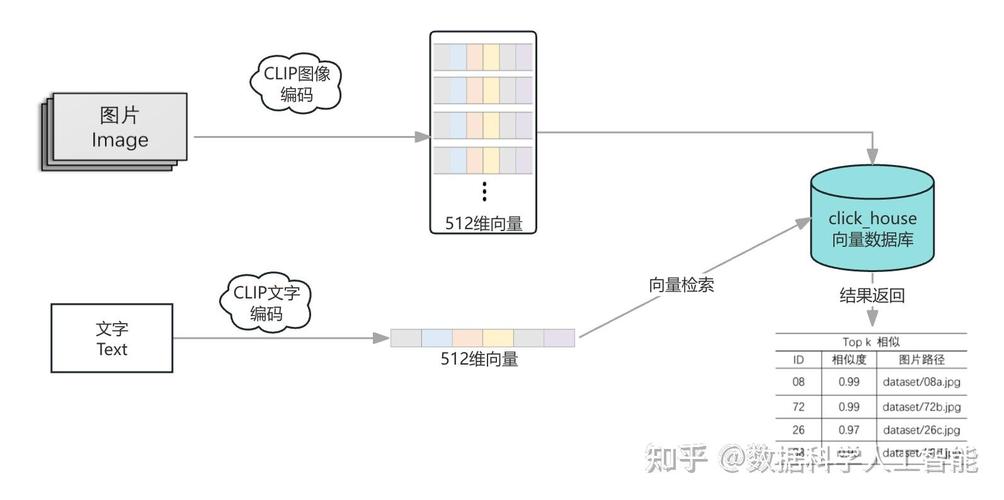 多模态检索跨模态特征匹配流程图
和传统文本检索的核心差异
传统文本检索的逻辑很直接,就是把你输入的文字,和内容提前带的标签、内嵌文字做匹配。你之前没给照片打”樱花””蓝裙子”的标签,就算照片本身有这些元素,也搜不出来。
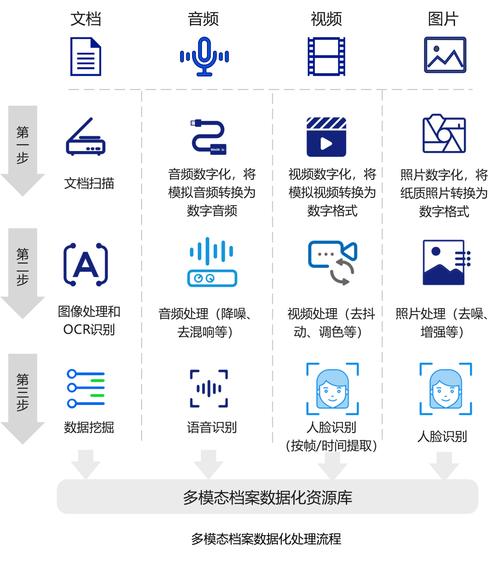
多模态检索是把图片里的色彩、物体、动作,音频里的旋律、音色,视频里的镜头节奏,全部转换成统一的特征向量做匹配,不依赖人工提前打标签。
现在不少企业的内部素材库也在应用这个能力,比如市场部找过往的宣传物料,不用逐层翻文件夹,直接描述素材的特征,就能把对应的海报、视频、现场录音片段都归集到一起。
您在实际使用中还遇到过哪些检索不准的情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:多模态内容检索:跳出文本标签限制的内容查找方式
文章链接:https://ttrenwu.com/geo/2806.html
