2026-10-12 21:46:53 分类:GEO优化
现在大模型生成内容随处可见,反幻觉技术基础就是帮我们挡住AI“一本正经胡说八道”的核心支撑。
反幻觉技术基础:到底解决什么问题
说白了就是帮AI改掉乱编事实的毛病。
比如你让AI整理某行业近期的融资事件,它说不定会编出几个根本没发生的项目,还能给你凑出融资金额和投资方。
这就是“幻觉”。
反幻觉就是从技术基础层面,减少这种无依据编造的情况。
说实话,做调研、写材料的人,没人想给AI擦屁股。对吧?
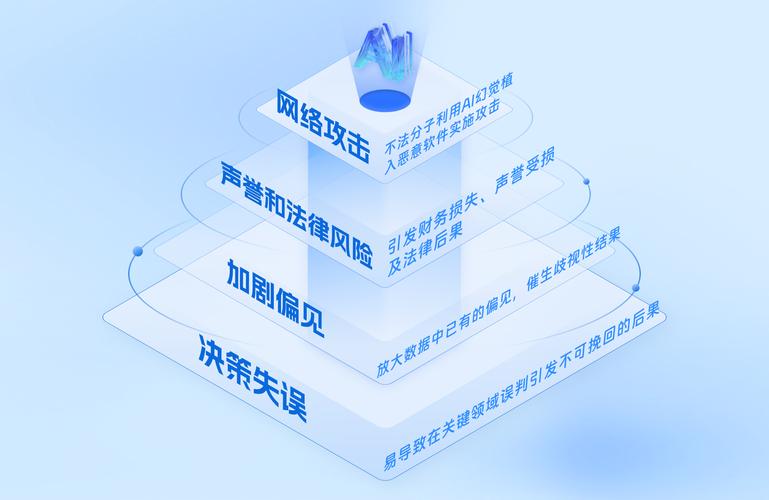 大模型AI幻觉生成错误融资信息示例图
通常它会用在对事实准确性要求较高的场景,比如企业内部AI知识库问答、公开搜索引擎的AI总结模块,还有医疗、法律这类专业领域的内容生成。
目前较为常见的两类基础实现思路
有意思的是,现在行业内没有通用的完美方案,大多是两种基础思路组合使用。
第一种是训练阶段前置干预,就是在训练大模型的时候,先过滤掉错误、无效的训练数据,再调整模型的预测逻辑,让它更倾向于输出有依据的内容,而非自由拼接编造。
从实操角度看,这种方式对训练数据质量要求高,整体改造成本也不低。
第二种是生成阶段后置校验,就是先让大模型产出内容,再通过独立的检索模块或者校验模型,核对内容中的事实点,和公开信源对不上就修正或者重生成。
举个例子,用户问某上市公司的最新年报净资产,模型出结果后,反幻觉模块会立刻拉取公开披露的年报数据核对,不对就修正后再输出。
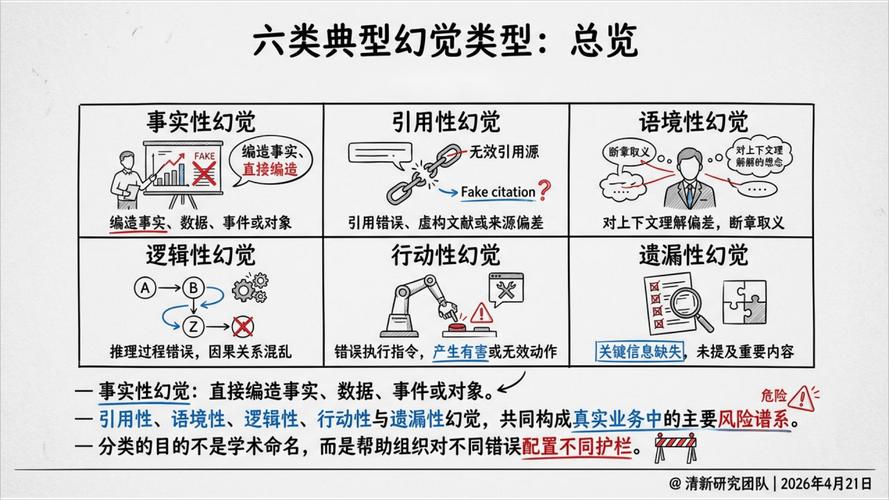 AI反幻觉生成后事实校验流程示意图
据一些用户反馈,后置校验的方案对现有模型改造成本更低,很多中小团队做内部AI工具都会优先选这个方向。
日常使用要留意的常见误区
 日常使用要留意的常见误区
不少人觉得加了反幻觉技术,就完全不会出错。其实不对。
反幻觉只是降低幻觉出现的概率,没法完全杜绝错误。
还有人觉得反幻觉一定会让AI输出变死板,失去创意能力。这个其实要看配置。
对事实要求高的场景,比如政务信息问答,本来就不需要天马行空的创意,影响很小。如果是做创意写作,只要调低反幻觉的干预强度就可以,不会完全卡死。
需要留意的是,不同场景对幻觉的容忍度不一样,要匹配不同强度的反幻觉方案,不能直接套通用模板。
您在实际使用AI工具的时候,遇到过哪些离谱的AI幻觉?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:拆解AI内容生成的事实防火墙
文章链接:https://ttrenwu.com/geo/2724.html
